

Redakcja
bypoznan.pl

,
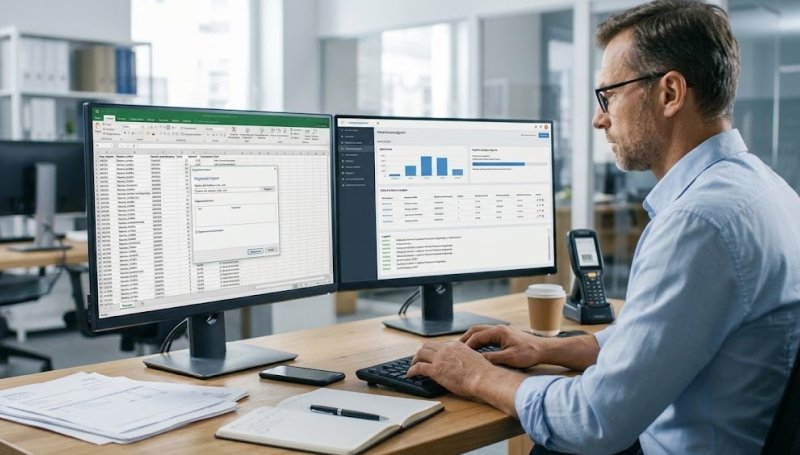
Wdrożenie programu do inwentaryzacji rzadko zaczyna się od pustej bazy. Firma ma już ewidencję środków trwałych w systemie księgowym, listę wyposażenia w Excelu, kartoteki w ERP albo kilka różnych źródeł danych prowadzonych równolegle przez księgowość, administrację i IT. Największym błędem byłoby przepisywanie tych informacji ręcznie. Przy kilku tysiącach rekordów oznacza to nie tylko wiele godzin pracy, ale przede wszystkim bardzo duże ryzyko literówek, pominięć i utworzenia duplikatów.
Dlatego jednym z pierwszych etapów wdrożenia powinien być import danych. Sam mechanizm zwykle nie jest skomplikowany - trudniejsze okazuje się przygotowanie źródła. Jeden system zapisuje numer inwentarzowy jako tekst, drugi jako liczbę, w Excelu nazwa lokalizacji występuje w pięciu wariantach, a w części kartotek brakuje informacji o użytkowniku. Dobry import nie polega więc na wczytaniu dowolnego pliku i kliknięciu „dalej”. Najpierw trzeba zdecydować, które dane są wiarygodne, uporządkować strukturę i ustalić, co ma być jednoznacznym identyfikatorem każdego składnika.
Najlepszym źródłem jest zazwyczaj system, w którym prowadzona jest oficjalna ewidencja majątku. Może to być system księgowy, ERP albo wyspecjalizowany moduł środków trwałych. Excel często pełni rolę dodatkowego źródła, ponieważ zawiera informacje operacyjne, których nie ma w księgowości - aktualny pokój, nazwisko użytkownika, numer seryjny komputera czy wewnętrzną kategorię wyposażenia. Problem zaczyna się wtedy, gdy oba źródła pokazują coś innego. Jeśli księgowość przypisuje komputer do administracji, a arkusz IT wskazuje konkretnego pracownika, przed importem trzeba ustalić, które pole ma być nadrzędne.
Minimalny zestaw danych powinien obejmować jednoznaczny numer składnika oraz jego nazwę. W praktyce warto jednak przenieść także kategorię, lokalizację, osobę odpowiedzialną, numer seryjny, status, datę przyjęcia i inne informacje wykorzystywane później podczas spisu. Nie ma sensu importować każdej kolumny tylko dlatego, że istnieje w starym systemie. Jeżeli przez dziesięć lat nikt nie korzystał z pola „uwagi 3”, można zastanowić się, czy rzeczywiście powinno ono być przenoszone do nowej bazy.
Przy większych wdrożeniach warto przed importem zbudować prostą tabelę mapowania: kolumna ze starego systemu, odpowiadające jej pole w nowym programie oraz reguła przekształcenia. To szczególnie ważne przy lokalizacjach i kategoriach. Jeżeli jedna aplikacja zapisuje „Budynek A / piętro 2 / pokój 214” w jednej kolumnie, a druga oczekuje trzech osobnych poziomów struktury, dane trzeba odpowiednio rozdzielić przed wczytaniem.
Najlepszy plik importowy jest zwykle znacznie prostszy niż arkusz używany na co dzień przez pracowników. Jeden wiersz powinien odpowiadać jednemu składnikowi, a każda kolumna jednemu rodzajowi informacji. Nie powinno być scalonych komórek, dodatkowych tytułów pomiędzy danymi, pustych wierszy oddzielających działy ani komentarzy wpisanych obok tabeli. To, co dla człowieka wygląda czytelnie, dla mechanizmu importującego może oznaczać całkowicie nieprzewidywalną strukturę.
Szczególną uwagę trzeba poświęcić numerom inwentarzowym. Excel lubi interpretować dane po swojemu, dlatego numer 000154 może po otwarciu pliku zmienić się w 154. Podobny problem dotyczy oznaczeń przypominających daty oraz długich numerów. Jeżeli identyfikator ma zera wiodące albo zawiera litery i znaki specjalne, kolumnę najlepiej traktować jako tekst. Daty również powinny mieć jeden ustalony format w całym pliku, zamiast mieszanki 2026-10-01, 01.10.2026 i 1 października.
Warto też ujednolicić nazwy. Dla człowieka „Magazyn główny”, „MAGAZYN GŁÓWNY” oraz „Mag. Główny” mogą oznaczać to samo miejsce. System może jednak utworzyć trzy oddzielne lokalizacje. Podobnie dzieje się z nazwiskami użytkowników, kategoriami oraz nazwami oddziałów. Kilkadziesiąt minut poświęconych na oczyszczenie słowników przed importem potrafi oszczędzić wiele godzin późniejszego poprawiania bazy.
Jeśli wykorzystywany jest CSV, trzeba dodatkowo zwrócić uwagę na separator oraz kodowanie znaków. Polskie litery zamienione po imporcie w przypadkowe symbole to klasyczny przykład problemu, który nie ma nic wspólnego z jakością danych, lecz wyłącznie ze sposobem zapisania pliku.
Komunikat „brak wymaganego pola” zwykle oznacza, że w którymś wierszu nie ma wartości w kolumnie uznanej przez system za obowiązkową. Jeśli jest to numer inwentarzowy, taki rekord nie powinien być importowany bez wyjaśnienia, ponieważ później nie będzie można go jednoznacznie rozpoznać. „Nieprawidłowy format daty” najczęściej pojawia się wtedy, gdy w jednej kolumnie znajdują się różne formaty albo obok dat wpisano komentarze.
„Duplikat identyfikatora” jest poważniejszym ostrzeżeniem. Może oznaczać rzeczywisty błąd ewidencji, ale czasem wynika z tego, że jeden środek trwały został w arkuszu rozpisany na kilka wierszy. Nie powinno się automatycznie dodawać do numeru kolejnej cyfry tylko po to, żeby import przeszedł. Trzeba najpierw ustalić, czy mamy do czynienia z dwoma składnikami, czy z jednym rekordem opisanym dwa razy.
Komunikaty typu „wartość spoza słownika” pojawiają się natomiast wtedy, gdy program oczekuje istniejącej lokalizacji, kategorii lub statusu, a w pliku występuje nowa nazwa. Dobrym przykładem jest lokalizacja „Warszawa - biuro”, podczas gdy w programie utworzono wcześniej tylko „Warszawa”. W zależności od założeń wdrożenia trzeba albo utworzyć nową pozycję w słowniku, albo poprawić plik.
Częstym problemem jest także „nieprawidłowy typ danych”. Program oczekuje liczby, a dostaje zapis „1200 zł”; oczekuje daty, a otrzymuje „brak”; oczekuje jednego kodu lokalizacji, a w komórce znajdują się trzy wartości oddzielone przecinkami. Najlepszą metodą nie jest poprawianie błędów pojedynczo po każdym nieudanym imporcie, lecz wykorzystanie raportu błędów do oczyszczenia całego źródła i dopiero wtedy ponowne wczytanie danych.
W większości przypadków pierwszy import można wykonać za pomocą pliku wygenerowanego z systemu źródłowego. SAP, rozwiązania Comarch, Symfonia czy enova mogą w różnych konfiguracjach udostępniać dane poprzez raporty, eksporty lub mechanizmy integracyjne. Nie ma jednak jednego uniwersalnego pliku „z ERP”, który zawsze wygląda tak samo. Zakres pól zależy od używanego modułu, konfiguracji i sposobu prowadzenia ewidencji w konkretnej firmie.
Dlatego przed rozpoczęciem wdrożenia warto najpierw wykonać eksport próbny, obejmujący kilkadziesiąt pozycji. Na jego podstawie można ustalić mapowanie kolumn i sprawdzić, czy otrzymujemy wszystkie informacje potrzebne do późniejszego spisu. Dopiero po przetestowaniu warto przygotować pełną bazę. Jest to znacznie bezpieczniejsze niż zaimportowanie dziesięciu tysięcy rekordów i odkrycie po fakcie, że numery lokalizacji zostały przypisane do niewłaściwego pola.
W przypadku cyklicznej wymiany danych wygodniejszy może być moduł pozwalający przesyłać informacje pomiędzy programem a plikami Excel. Więcej informacji o takim rozwiązaniu można znaleźć pod adresem:
https://www.pwsk.pl/narzedziownia/modul-wymiany-danych-z-ms-excel/
Sam plik sprawdza się bardzo dobrze wtedy, gdy dane są przenoszone jednorazowo lub kilka razy w roku. Jeżeli jednak system inwentaryzacyjny ma codziennie otrzymywać nowe środki trwałe, zmiany użytkowników, likwidacje czy przesunięcia pomiędzy lokalizacjami, ręczne eksportowanie i importowanie kolejnych arkuszy szybko zaczyna być problemem. W takim przypadku warto rozważyć integrację poprzez API albo inny mechanizm automatycznej wymiany danych pomiędzy systemami.
API ma sens przede wszystkim wtedy, gdy dane powinny pozostawać aktualne bez pracy człowieka. Nowy komputer pojawia się w systemie ERP i automatycznie trafia do systemu odpowiedzialnego za ewidencję oraz inwentaryzację. Zmiana lokalizacji może być przesyłana w drugą stronę albo synchronizowana według ustalonych zasad. Takie rozwiązanie wymaga większego przygotowania na etapie wdrożenia, ale przy regularnej wymianie tysięcy rekordów eliminuje powtarzalne operacje wykonywane ręcznie.
Excel nadal pozostaje bardzo dobrym rozwiązaniem w mniejszych organizacjach oraz tam, gdzie wymiana odbywa się sporadycznie. Ważne jest tylko, aby ustalić, co stanie się przy kolejnym imporcie. Czy rekord o tym samym numerze zostanie zaktualizowany, pominięty czy utworzony ponownie? Bez tej zasady łatwo zbudować bazę, w której ten sam komputer występuje kilka razy.
Po pierwszym imporcie warto więc wykonać kontrolę duplikatów według kilku pól: numeru inwentarzowego, numeru seryjnego, a w niektórych przypadkach również nazwy i lokalizacji. Trzeba jednak uważać na automatyczne scalanie. Dwie identyczne drukarki stojące w jednym pokoju mogą być całkowicie poprawnymi, oddzielnymi składnikami. Duplikatem nie jest podobny opis, lecz dwa rekordy odnoszące się do tego samego rzeczywistego obiektu.
Najlepszy moment na porządki przypada właśnie przed pierwszą inwentaryzacją w nowym systemie. Jeżeli w bazie znajdują się trzy wersje tej samej lokalizacji, stare numery po zlikwidowanych urządzeniach i rekordy bez identyfikatorów, spis tylko ujawni skalę problemu. Dobrze przygotowany import pozwala natomiast rozpocząć pracę od uporządkowanej struktury i wykorzystać pierwszą inwentaryzację do potwierdzenia rzeczywistego stanu, a nie do naprawiania wieloletnich błędów w arkuszach.
Import danych jest więc czymś więcej niż techniczną operacją pomiędzy dwoma programami. To moment, w którym firma musi zdecydować, które informacje są prawidłowe, jak mają wyglądać słowniki i co będzie podstawowym identyfikatorem majątku. Jeśli ten etap zostanie wykonany dobrze, późniejszy spis, wymiana danych i kolejne aktualizacje stają się znacznie prostsze. Jeśli zostanie potraktowany jako szybkie „wgranie Excela”, problemy starego systemu zostaną po prostu przeniesione do nowego.
Więcej informacji o rozwiązaniach wspierających ewidencję, inwentaryzację i wymianę danych można znaleźć na stronie:

bypoznan.pl

Poznański serwis informacyjno - rozrywkowy
Z życia miasta, czyli najważniejsze newsy związane z naszym miastem
Publikujemy, doradzamy, oceniamy, komentujemy
E-mail: miasto@bypoznan.pl


Zostaw komentarz